从血压计到篮球场:我把 YOLOv8 塞进 iOS App 的落地笔记
一个独立开发者的端侧 AI 实践:当系统 OCR 认不出七段码,我为它找到了开源的检测模型;而这套”检测 + 规则 + 时序”的架构,恰好回答了”YOLOv8 能不能自动识别篮球进球”这个问题。
一、故事的起点:Vision OCR 翻车了
我在做「TA-时间助手」(一个 iOS 时间记录应用,App Store 下载)的血压记录功能时,想做一个”扫一下血压计,数字自动录入”的扫描页。
第一反应当然是用苹果原生方案——Vision 框架的 VNRecognizeTextRequest,一行代码就能跑 OCR,免费、离线、无需训练。对说明书上的”mmHg”、”Omron”这些印刷体文字,它识别得很好。
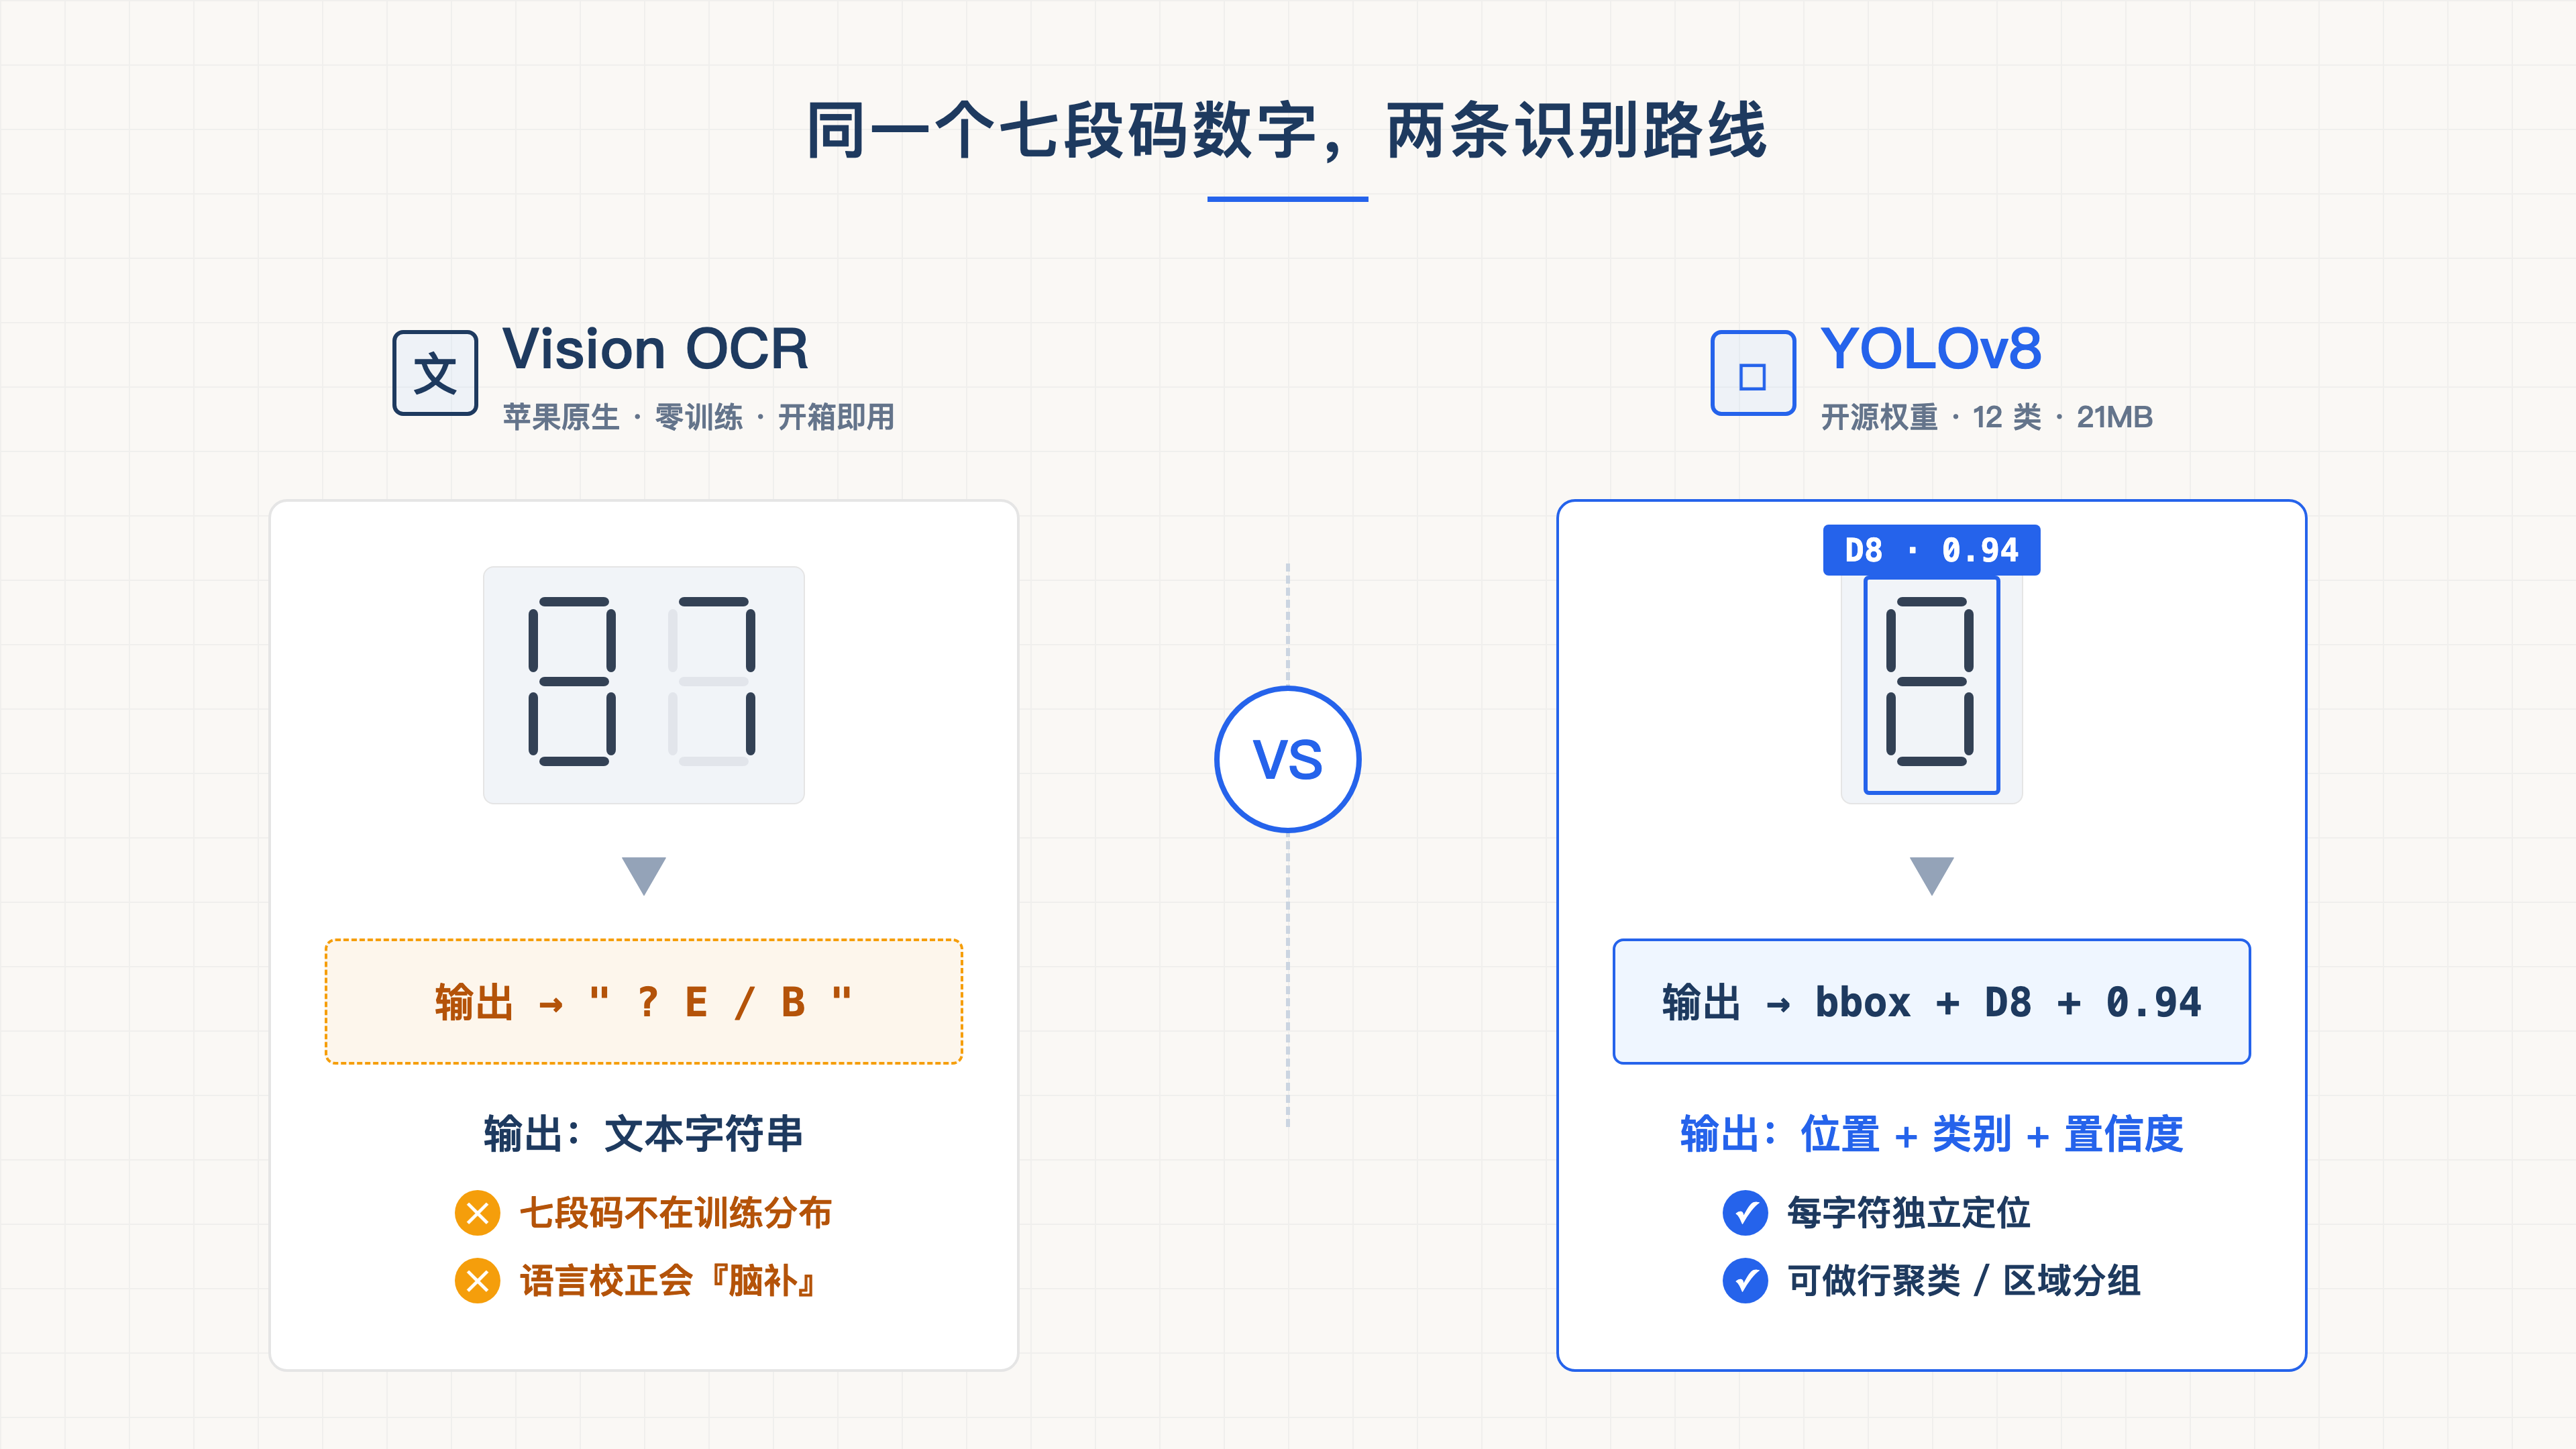
但血压计屏幕上的数字是七段数码管(LCD 七段码)——那种由 7 条发光段拼出来的数字。Vision OCR 对它的识别率极低,因为它压根不是”文字”:OCR 的训练分布是印刷体和场景文字,7 段码数字”1”只是两根竖条、”7”和”1”在像素层面几乎是几何图形而非字符。更麻烦的是语言校正还会”脑补”,把认不清的数字猜成一个像模像样的词。
这一课很关键:端侧模型不是万能插件,先搞清楚它的训练分布里有没有你的目标。
二、方案演进:三条路,一个能走通
方案 1:Vision OCR(弃用于数字)
保留 VNRecognizeTextRequest,但只负责识别屏幕上的印刷体标签(”高压”、”mmHg”、”Omron”),配置了 recognitionLevel = .accurate、中英文语言、customWords 关键词加权。数字识别?交给别人。
方案 2:传统 CV 七段码分析(OpenCV 风格)
写了一个纯几何方案的 SevenSegmentReader,不依赖任何模型:
- Vision 矩形检测定位 LCD 屏,透视校正拉正;
- Core Image 灰度 → 高对比度 → Otsu 自适应二值化 → 极性校正(滤掉 LCD 残影);
- 水平投影切出三行(高压/低压/脉搏);
- 连通域(Union-Find)切出单个数字;
- 在数字框的 7 个固定归一化位置采样亮像素占比;
- 查七段真值表
[A,B,C,D,E,F,G] → 0~9。
它成了可靠的兜底,但传统 CV 的脆弱性也众所周知:光照、反光、倾斜、残影,任何一环崩了整条链路就崩。
方案 3:YOLOv8 开源模型(最终主力)
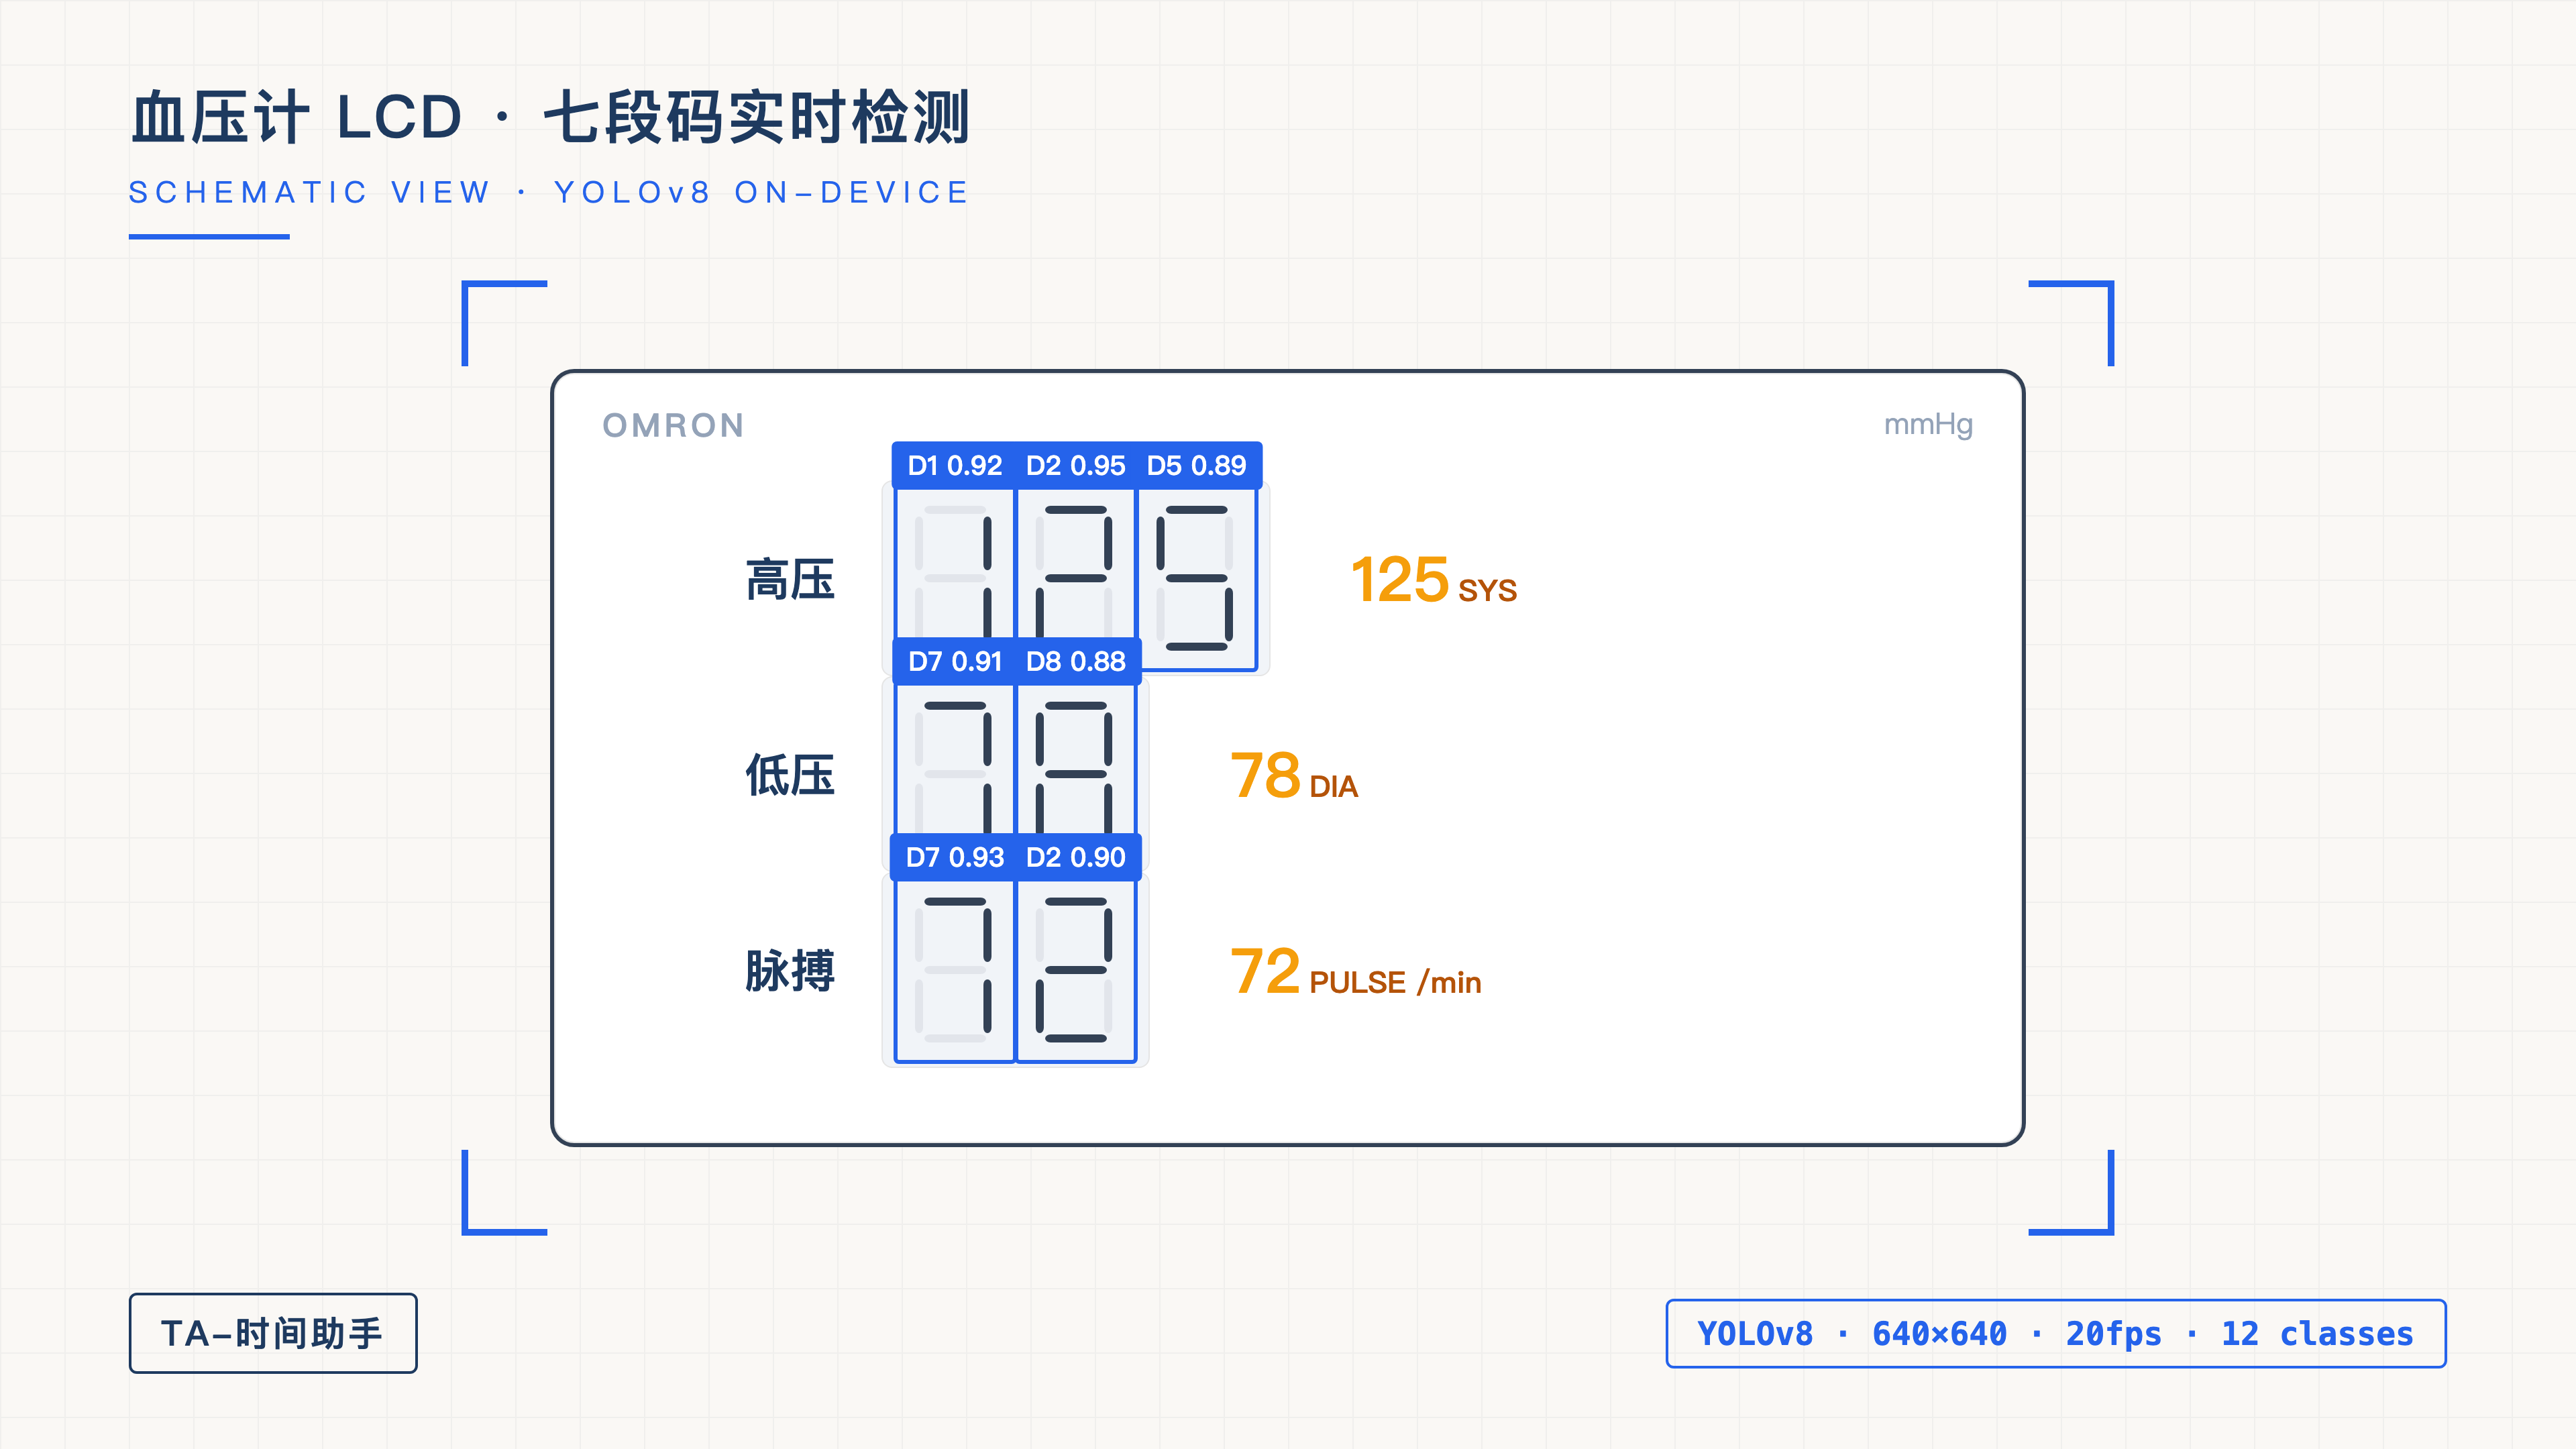
换一个思路:不自己训练,去开源社区找一个现成的检测模型,把问题变成:在整幅相机帧上,检测出每个数字的位置和类别。
- 在 GitHub 上找到了社区训练好的 YOLOv8 权重
gh_yolov8_best——训练数据是公开的 MetersOCR 数据集(血压计、血糖仪等家用设备屏幕照片,Roboflow 托管版 MetersOCR7-1),12 个类别:D0~D9(数字 0-9)、TOT(整数区标记)、TOTDEC(小数区标记)——后两个”区域类”是点睛之笔,模型不仅告诉你数字是什么,还告诉你它属于哪个功能区; - 用 Ultralytics 一行命令导出 Core ML(
.mlpackage),FP16 量化后21MB,640×640 输入,内置 NMS; - iOS 侧零第三方依赖:
MLModel→VNCoreMLModel→VNCoreMLRequest,Vision 框架统一调度,GPU/ANE 自动接管。
三、真正的工程量在后处理链上
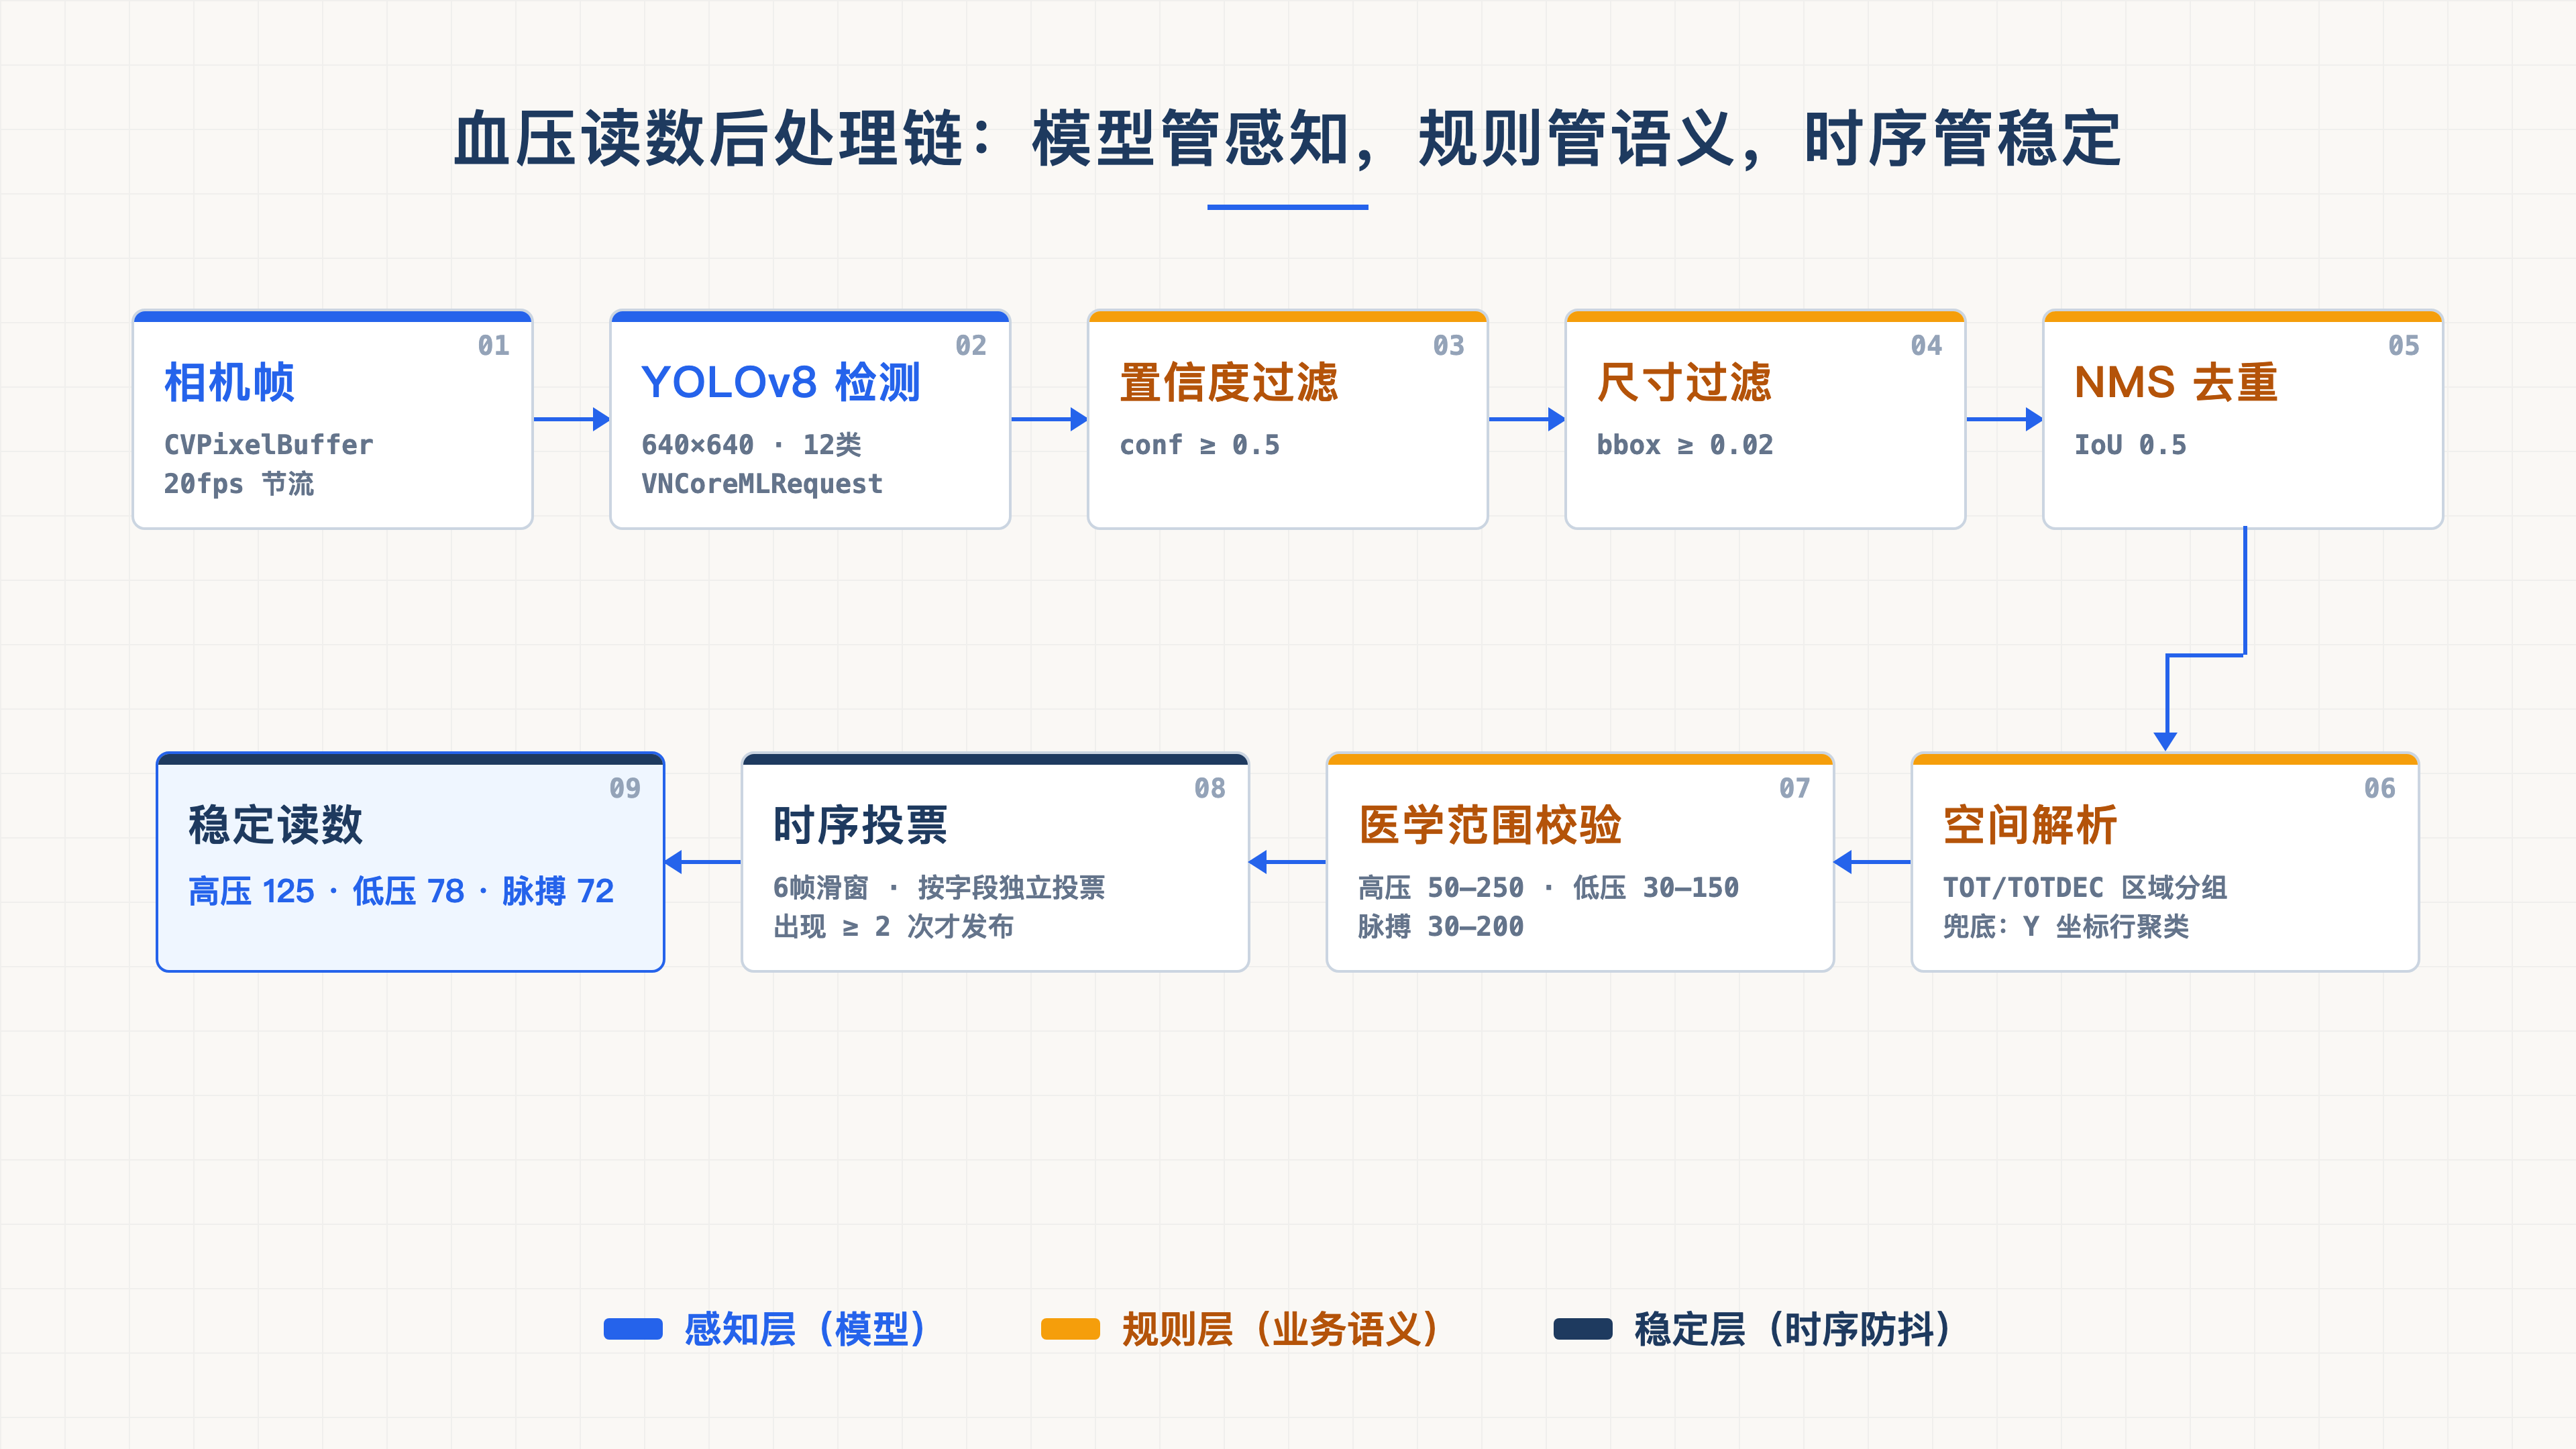
很多人以为”找到模型就完事了”。实际跑起来,模型默认置信度阈值 0.25 会产生大量误检框,我的最终处理链长这样:
1 | 相机帧 (CVPixelBuffer, 20fps 节流) |
每一步都对应真实翻过车:
- 时序投票:单帧识别会抖动,”高压 125”下一帧变”高压 128”。我维护一个 6 帧滑窗,高压/低压/脉搏三个字段独立统计众数,出现次数达标才更新 UI——脉搏误读不再连累整条结果。
- 按字段置空而非整体丢弃:早期版本一个字段超范围就丢弃整个结果,导致脉搏偶尔误读时高压低压也被清空,用户观感极差。
- 竖屏方向:后置摄像头视频缓冲区是横向的,
VNImageRequestHandler必须传orientation: .right,否则检测框全部转置。
四、YOLOv8 vs iOS 原生 OCR:一张表说清
| 维度 | Vision OCR (VNRecognizeTextRequest) |
YOLOv8 检测模型 (Core ML) |
|---|---|---|
| 输出 | 文本字符串(识别) | bbox + 类别 + 置信度(检测+定位) |
| 适配成本 | 零训练,开箱即用 | 有现成权重则零训练;否则自建数据集 |
| 覆盖范围 | 印刷体/场景文字,通用 | 只认训练过的类,但可以是任何东西 |
| 七段码/LCD | 识别率极低(不在训练分布内) | 12 类开源模型,主战场 |
| 空间推理 | 只有文本行级 bbox | 每个字符独立定位 → 可做行聚类、区域分组 |
| 误报控制 | 语言校正可能”脑补” | 置信度阈值 + NMS + 尺寸过滤,可精调 |
| 资源占用 | 系统服务,按需加载 | 21MB 包体 + 常驻内存,需节流(20fps) |
| 进化方式 | 等苹果更新 | 自己迭代数据集 |
结论不是”谁替代谁”,而是分工:在这个 App 里,YOLOv8 负责 LCD 数字(它的”专属领域”),Vision OCR 负责印刷体标签,SevenSegmentReader 兜底。三条链路按优先级降级,任何一条挂掉都有下家。
五、延伸:YOLOv8 能识别篮球进球吗?
写到这里,自然引出一个更有趣的问题——这套经验能不能迁移到”篮球比赛视频进球自动识别”?
直接回答:YOLOv8 能干这活的一半,但单靠它判定不了进球。
为什么单帧检测不够
- 进球是事件,不是物体。 检测模型回答的是”这一帧里球在哪、筐在哪”;而进球的定义是”球从上向下穿过篮筐平面”——这是一个跨帧的时空事件,信息根本不在单帧里。
- 遮挡与丢检。 篮球比赛中球频繁被球员、篮板、篮筐前沿遮挡,检测必然丢帧。靠”连续帧里球心都在筐内”做判定,一次遮挡就漏判。
- 尺度问题。 全场机位下篮球往往只占几个像素,YOLOv8 输入缩到 640×640 后小目标进一步退化,需要高分辨率切片推理或专门的小目标数据增强。
- 2D 检测 ≠ 3D 语义。 图像上球框落在篮筐 bbox 里,不代表球在筐里——透视关系下球可能在筐前、筐后。需要轨迹方向(自上而下穿过)甚至多机位几何才能确认。
- 帧率物理极限。 30fps 下球可能在相邻两帧之间完成穿越,判定逻辑必须基于轨迹插值而非逐帧位置。
可行的架构:和血压扫描同构
1 | 视频流 |
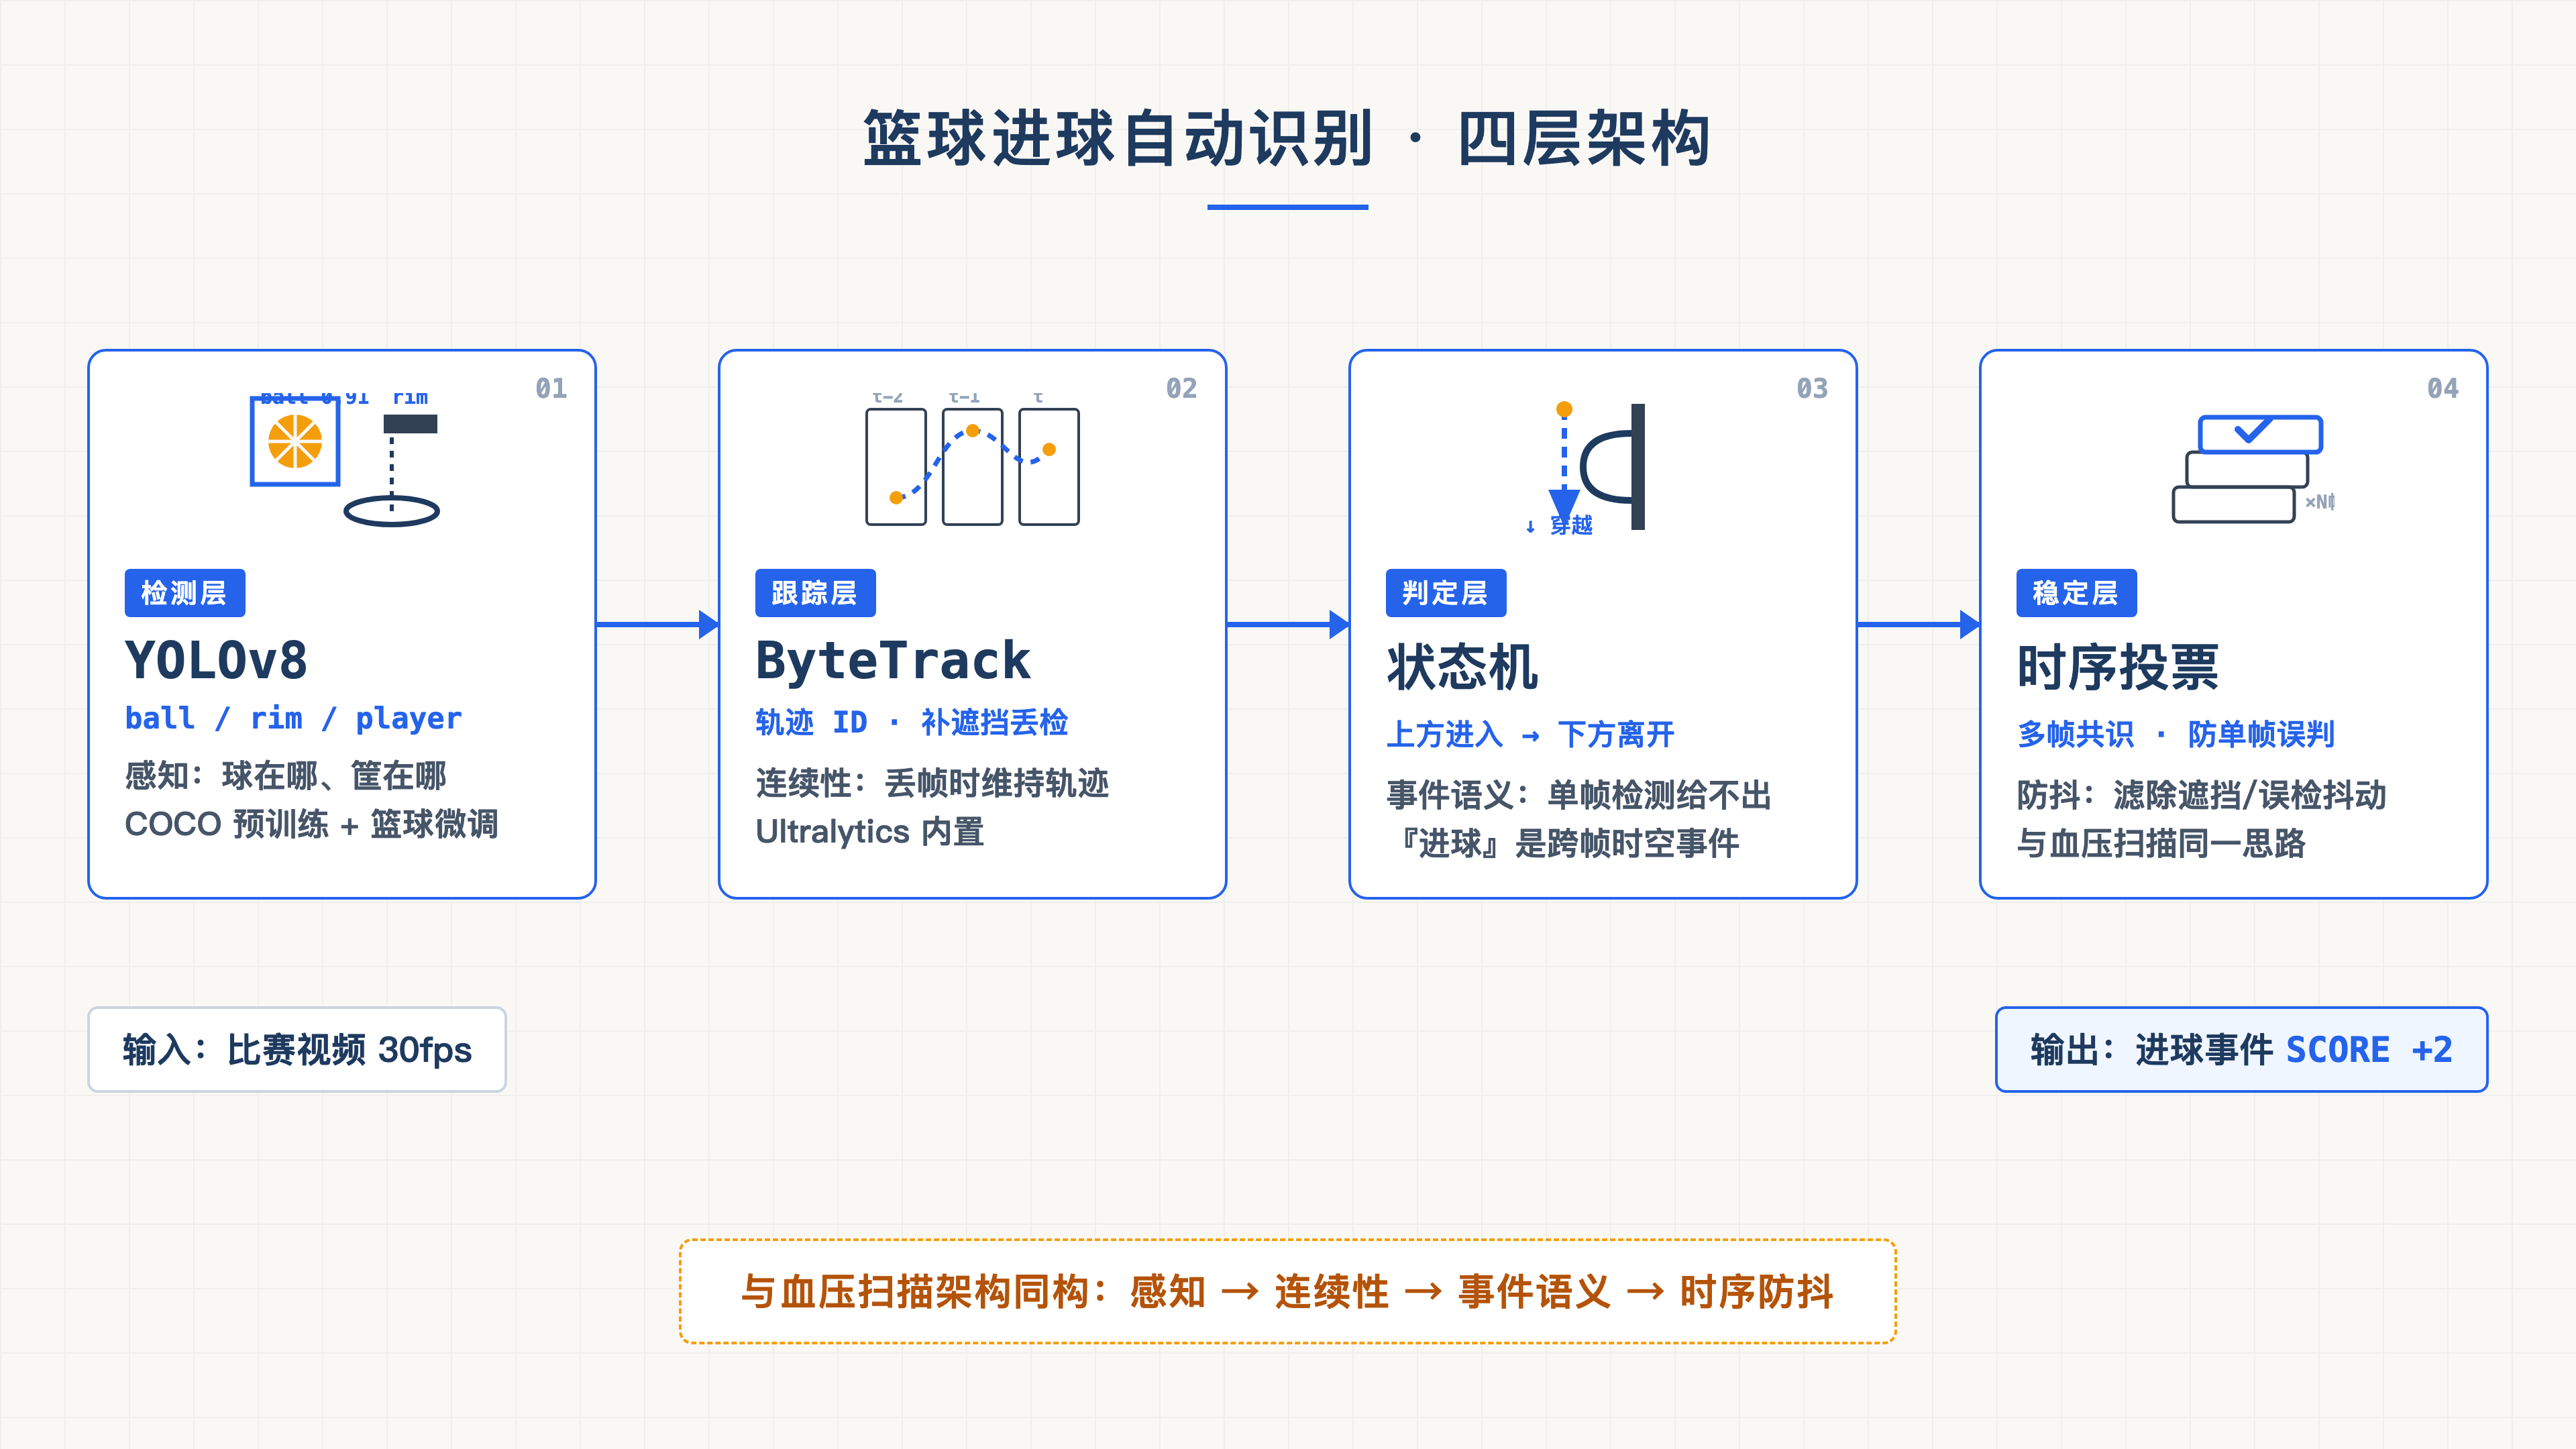
这不就是第三节那条后处理链的翻版吗?模型负责感知(球/筐在哪),规则负责语义(穿过=进球),时序负责稳定(多帧投票防误判)。 我在血压计上学到的心法——置信度过滤、区域分组、范围校验、多帧投票——可以原封不动地平移到球场。
如果再进一步:YOLOv8-Pose 还能检测球员骨架做投篮动作分析,判定层也可以升级成 LSTM/Transformer 学事件分类——但骨架依然是”检测层打地基”。
六、端侧 AI 的三条心法
回看整个项目,我的收获可以浓缩成三句话:
- 先问训练分布,再谈模型选型。 Vision OCR 很强,但七段码不在它的世界观里;YOLOv8 很强,但只认训练时喂过的类。没有”最好的模型”,只有”分布匹配的模型”。
- 模型只负责感知,语义靠规则补完。 “高压 125”这个结论里,YOLO 只贡献了”5 个数字框 + 各自位置和类别”,行聚类、区域分组、医学范围校验全是规则代码——这部分恰恰是最贴业务、最不可替代的工程量。
- 稳定性靠时序,不靠单帧。 从单帧识别到 6 帧投票,误读率数量级下降。任何实时识别系统,时序平滑都应该是标配而非可选。
端侧 AI 的门槛正在快速降低:开源社区有现成权重,Ultralytics 一行命令导出 Core ML,Vision 框架无缝接入。真正的壁垒不在”会用模型”,而在把模型嵌进业务的那条后处理链里。
「TA-时间助手」是一个 iOS 时间记录应用,支持血压等健康数据扫描录入 → App Store 下载。本文所有代码细节均来自真实工程实现。